RAMDeck Tawarkan Cara Murah Menjalankan AI Besar
TradeMAV menawarkan RAMDeck, hub yang menghubungkan beberapa perangkat untuk menjalankan model AI besar. Namun, performanya bergantung pada konfigurasi dan spesifikasi hub belum diungkap.
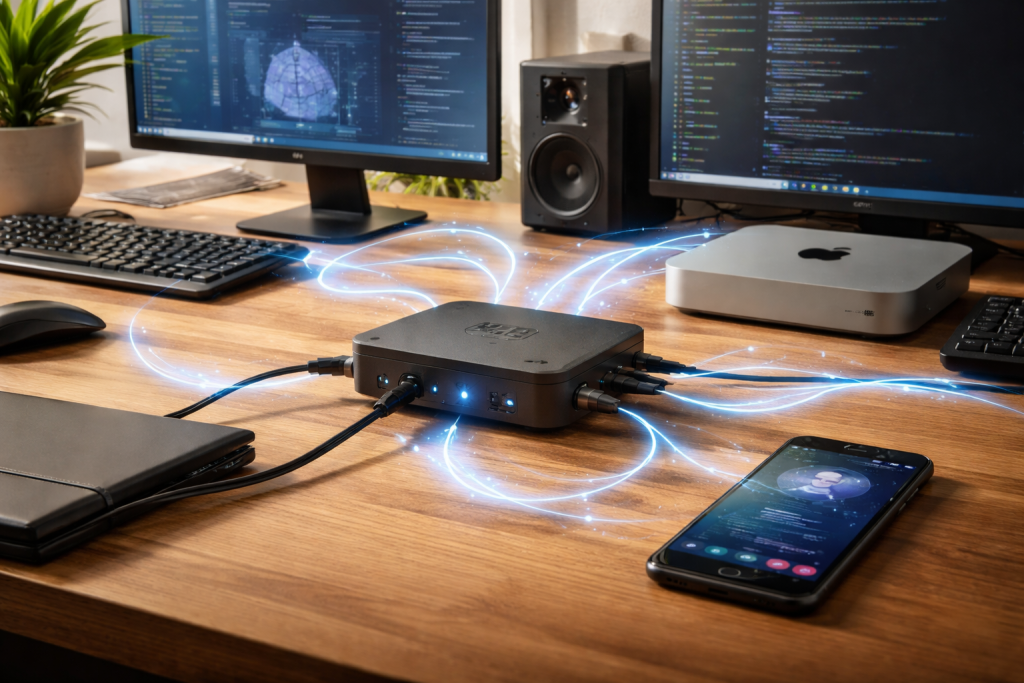
RAMDeck ditawarkan TradeMAV sebagai cara menjalankan model kecerdasan buatan (AI) berukuran besar tanpa harus membeli RAM tambahan. Hub yang tengah dikampanyekan di Indiegogo itu menghubungkan Windows PC, Mac, komputer Linux, dan ponsel Android agar kapasitas memori perangkat-perangkat tersebut dapat dimanfaatkan bersama.
Perangkat ini dibanderol 109 dollar AS untuk pendukung awal. Kampanye dengan target pendanaan 10.000 dollar AS tersebut dijadwalkan berakhir pada 8 November 2026. Namun, harga itu belum berarti pengguna membeli produk yang sudah tersedia: RAMDeck masih berupa proyek crowdfunding, sementara spesifikasi teknis hub belum dijabarkan secara lengkap.
RAMDeck membagi beban model ke beberapa perangkat
Gagasan di balik RAMDeck berangkat dari kebutuhan menjalankan model AI yang ukurannya melampaui kemampuan satu komputer. Alih-alih mengandalkan satu perangkat dengan memori besar, sistem membagi lapisan model ke beberapa mesin yang tersambung dalam jaringan rumah. Tiap mesin menyimpan bagiannya di memori lokal, sementara hasil perhitungan antara dikirim melalui jaringan saat model menghasilkan token.
Dengan demikian, istilah “pooling RAM” tidak berarti seluruh memori perangkat benar-benar dilebur pada tingkat perangkat keras. RAMDeck mengatur pembagian pekerjaan antarmesin, bukan membuat satu kumpulan memori fisik yang dapat diakses seolah-olah berada dalam satu komputer.
TradeMAV mengaitkan tawaran ini dengan lonjakan harga memori. Data ritel Jerman dari 3DCenter yang dikutip perusahaan menunjukkan harga DDR5 pada pertengahan Agustus mencapai 486 persen dari harga pada Juli 2025. Dalam kisah asal-usul proyek, TradeMAV juga menyebut harga kit DDR5 64 GB naik dari sekitar 191 dollar AS pada Agustus 2025 menjadi 1.118 dollar AS setahun kemudian.
Tekanan pasokan diperkirakan tidak segera reda. Samsung disebut telah memberi tahu analis bahwa kelangkaan dapat berlangsung hingga 2028, sedangkan ketua SK Group memperingatkan kondisi itu bisa bertahan sampai 2030. Angka-angka tersebut menjadi latar bagi solusi yang mencoba memanfaatkan perangkat yang sudah dimiliki pengguna.
Perangkat lunak terbuka, tetapi spesifikasi hub belum jelas
Repositori GitHub TradeMAV menjelaskan bahwa setiap perangkat yang berkontribusi menjalankan server ggml RPC dari llama.cpp. Sistem itu dapat dikendalikan oleh koordinator yang kompatibel melalui protokol standar llama.cpp RPC. Perusahaan menyarankan pengguna menguji jalurnya dengan perintah llama-cli.
Nilai tambah yang ditawarkan TradeMAV berada pada lapisan orkestrasi: menemukan perangkat secara otomatis, mengatur penempatan lapisan model dengan mendahulukan GPU cepat, menangani kegagalan, serta menyediakan dashboard dan API yang kompatibel dengan OpenAI. Fitur-fitur ini ditujukan untuk membuat konfigurasi beberapa mesin lebih mudah digunakan.
Meski demikian, informasi mengenai hub RAMDeck sendiri masih terbatas. TradeMAV belum mencantumkan prosesor, kapasitas memori, jenis port, maupun konsumsi daya perangkat tersebut. Perusahaan juga mengakui dalam panduan pooling bahwa pengguna yang nyaman memakai skrip terminal dapat memilih jalur DIY berbasis perangkat lunak sumber terbuka secara gratis.
Penggabungan perangkat untuk menjalankan inferensi AI bukan pendekatan baru. Proyek open source exo dari Exo Labs telah menawarkan penemuan perangkat otomatis dan API lintas komputer, ponsel, serta komputer papan tunggal sejak setidaknya awal 2025. Di segmen premium, Apple menyebut Mac Studio M5 Ultra mendukung clustering melalui Thunderbolt 5 dengan RDMA; menurut klaim perusahaan, empat mesin dapat menghasilkan kecepatan inferensi hingga tiga kali satu mesin.
RAMDeck mengutamakan kapasitas, bukan kecepatan
TradeMAV menonjolkan kompatibilitas dengan beragam perangkat, termasuk desktop Windows berbasis CUDA, Mac dengan Apple Silicon maupun prosesor Intel, mesin Linux, dan ponsel Android. Namun, perusahaan juga mengingatkan bahwa memori yang dikumpulkan menukar kecepatan dengan kapasitas. Bagi pengguna yang mengutamakan performa mentah, TradeMAV menyarankan GPU dengan VRAM lebih besar.
Hasil benchmark yang dipublikasikan menunjukkan perbedaan performa berdasarkan jenis model dan perangkat. Pada konfigurasi Beelink mini PC dengan RTX 3060 dan M4 Mac mini, Qwen3-Coder 30B mencatat 39 token per detik. Varian REAP 40B dari Qwen3-Coder-Next mencapai 16 token per detik. Sementara itu, model 7B yang mencapai 43 token per detik dijalankan pada RTX 3060, menurut keterangan TradeMAV.
Untuk model padat atau dense, angkanya jauh lebih rendah. Model 27B mencatat 1,92 token per detik pada empat perangkat. Model gpt-oss-120b dari OpenAI berjalan pada 1,37 token per detik dalam klaster enam perangkat. Dalam konfigurasi lima mesin berbeda, model 120B mencapai 3,1 token per detik setelah sekitar tujuh menit inisialisasi.
TradeMAV memosisikan kemampuan menjalankan model yang sebelumnya kehabisan memori sebagai manfaat utama, meski prosesnya bisa lambat. Bagi pengguna yang ingin mencoba sebelum membeli hub, llama.cpp RPC dan exo tersedia sebagai opsi yang dapat dijajal tanpa biaya perangkat RAMDeck. Sementara itu, calon pendukung Indiegogo perlu menimbang kenyamanan orkestrasi yang dijanjikan dengan keterbatasan performa, spesifikasi yang belum terbuka, dan risiko umum produk crowdfunding.